《赛车家谱》
品牌态度片 · 38 秒 · 24 镜
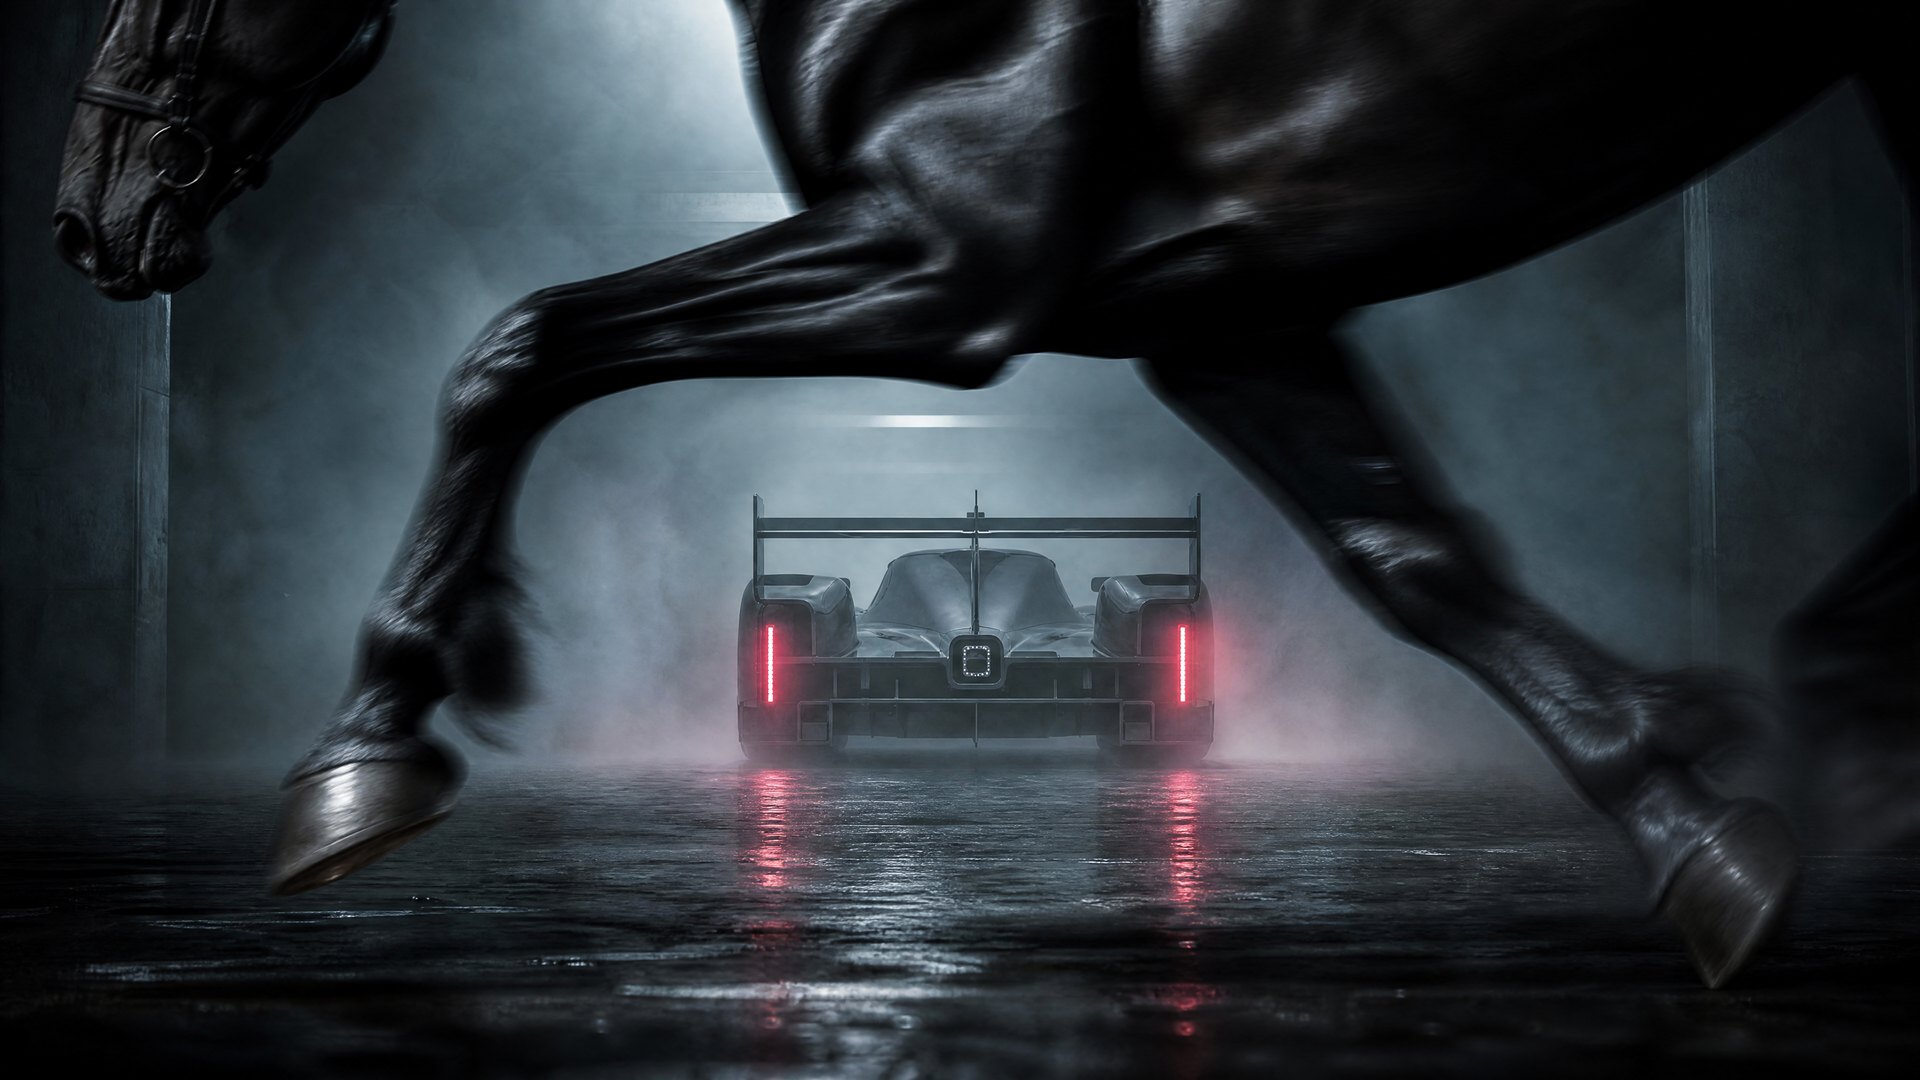
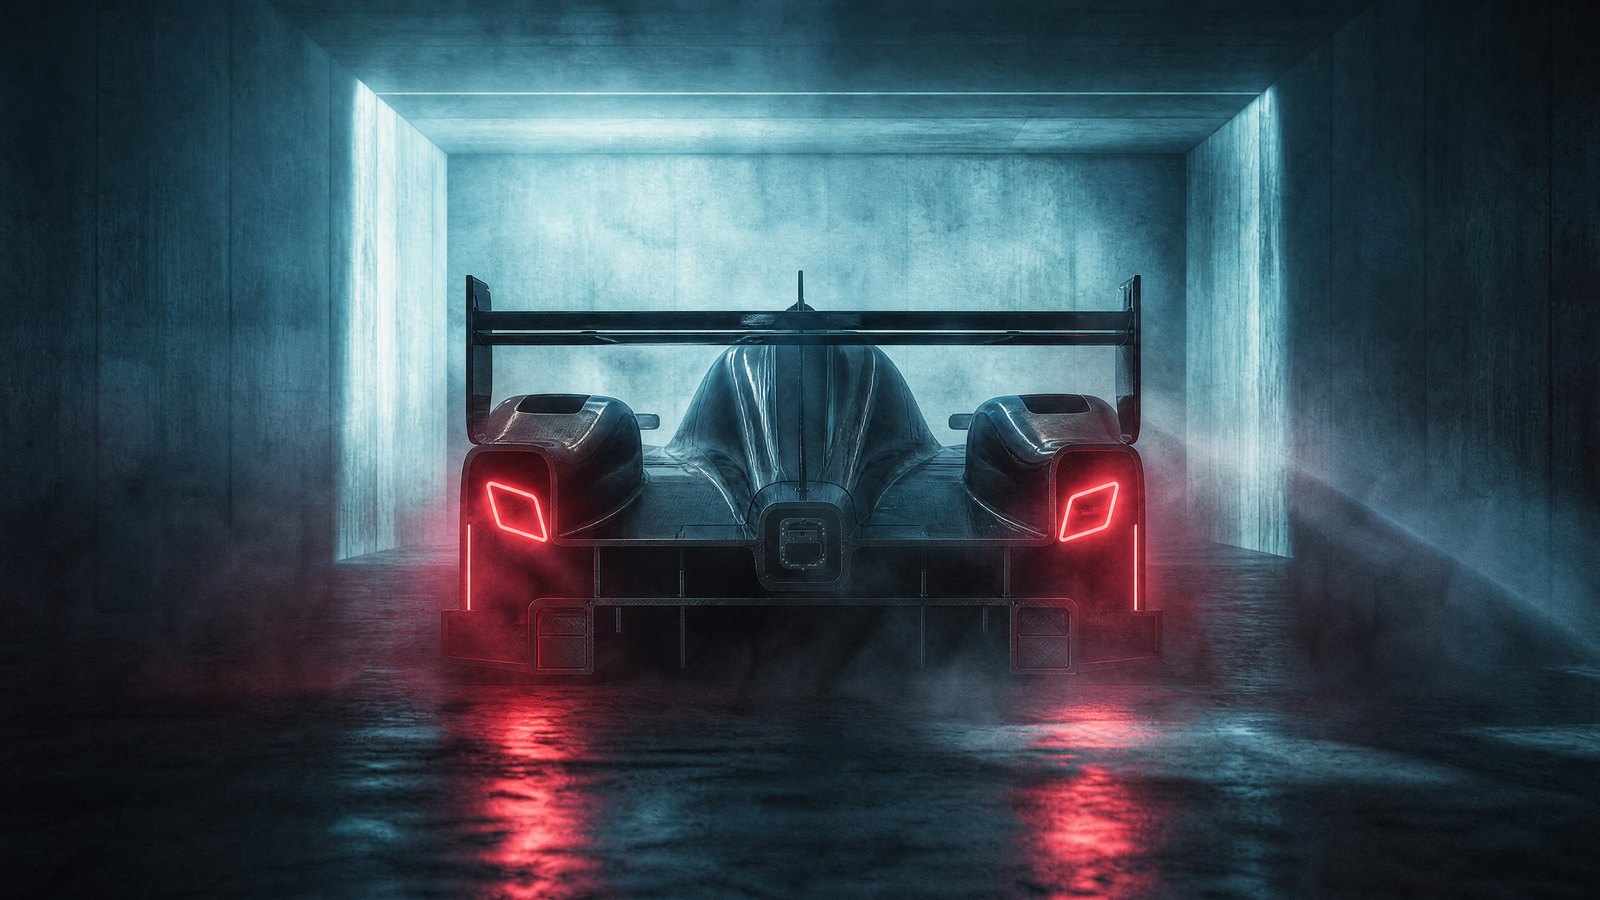
车从未动,是马眼带你看它跑完全世界。
纯 AI 品牌片。24 个镜头逐镜标注可行性,6 个高难度镜在分镜阶段就判定为不可生成, 改用实拍微距与后期合成。最终成片没有一帧靠反复抽卡碰出来。
| 镜头 | 判断 | 路径 |
|---|---|---|
| 马眼反射 | 不可生成 | 实拍微距 + 合成 |
| 高速跟拍 | 降级 | 生成底盘 + 实拍路面 |
| 车漆倒影 | 可生成 | Kling,3 次上限 |
| 雨夜追光 | 降级 | L2 局部合成 |
分镜表与逐镜判断记录,可在联系时索取。
拖动胶片 · 点击暂停

我是况逍遥,AI 商业宣传片视觉导演方向 / 美术指导,湖南工程学院环境设计专业 2027 届,2026 年在四川栗光云创做过视觉导演实习。 我的工作不是「把 AI 用得有多炫」,而是「在生成前就判断出哪个镜头该用哪个模型、 哪个镜头根本不该交给 AI」——用测试数据说话。
我自建了一套 27 场景 × 4 模型的 AI 能力地图,覆盖 Kling / Vidu / Sora / Runway 的精确能力边界。配合「可行性前置判断 + 降级路径设计 + 破坏性测试」三步方法, 在实习项目里把生成配额节省 67%,致命废片率与废片率双双降到 0。
三个项目做下来,真正留下来的不是某一张图,而是解决同一类问题的 skill—— 先锁什么、哪里放弃、参数怎么回填;下一次直接调用,不重新抽卡。
珠宝的反光和佩戴结构最难控制。我把「产品线稿 + 深度图 + ControlNet」固化成一套高保真还原 skill: 先用线稿锁轮廓,再用深度图控结构,材质阶段只调金属反射与宝石折射的 Prompt 权重。 还原度 90%+,20+ 组分镜共用一套参数。
先拆脚本,再出画面。把「镜头表 + 信息点 + 参考帧」做成一套分镜 skill, GPT Image 2 / Nano Banana Pro 一次批量出 30+ 组分镜;ControlNet + LoRA 锁住产品一致性, Kling / Seedance / Minimax 做动态预演,后期只处理节奏与合成。 30+ 组分镜,从脚本到预演一条流水线。
历史影像几乎找不到。我把年代、地理和光线写成一套场景重建 skill: Midjourney 按「1950s / Qinghai-Tibet Plateau / adobe house / kerosene lamp」出概念图, Seedance / Kling 让静帧有呼吸;再把「立德树人」「民族团结」转译成可拍的视觉符号。 历史素材空白补齐,抽象口号落成镜头。
以上数据来自 2026.06–09 实习期三个项目的内部统计。
每一个镜头,在按下生成键之前,就已经知道它值不值得生成。
从 15 秒到 2 分半。每组都停在一个具体判断上—— 判断就是作品的一部分。
品牌态度片 · 38 秒 · 24 镜
车从未动,是马眼带你看它跑完全世界。
纯 AI 品牌片。24 个镜头逐镜标注可行性,6 个高难度镜在分镜阶段就判定为不可生成, 改用实拍微距与后期合成。最终成片没有一帧靠反复抽卡碰出来。
| 镜头 | 判断 | 路径 |
|---|---|---|
| 马眼反射 | 不可生成 | 实拍微距 + 合成 |
| 高速跟拍 | 降级 | 生成底盘 + 实拍路面 |
| 车漆倒影 | 可生成 | Kling,3 次上限 |
| 雨夜追光 | 降级 | L2 局部合成 |
分镜表与逐镜判断记录,可在联系时索取。
《赛车家谱》完整成片 · 38 秒 · 有声 / 点击播放
拆解
皮克斯风格短片 · 15 秒 · 6 镜
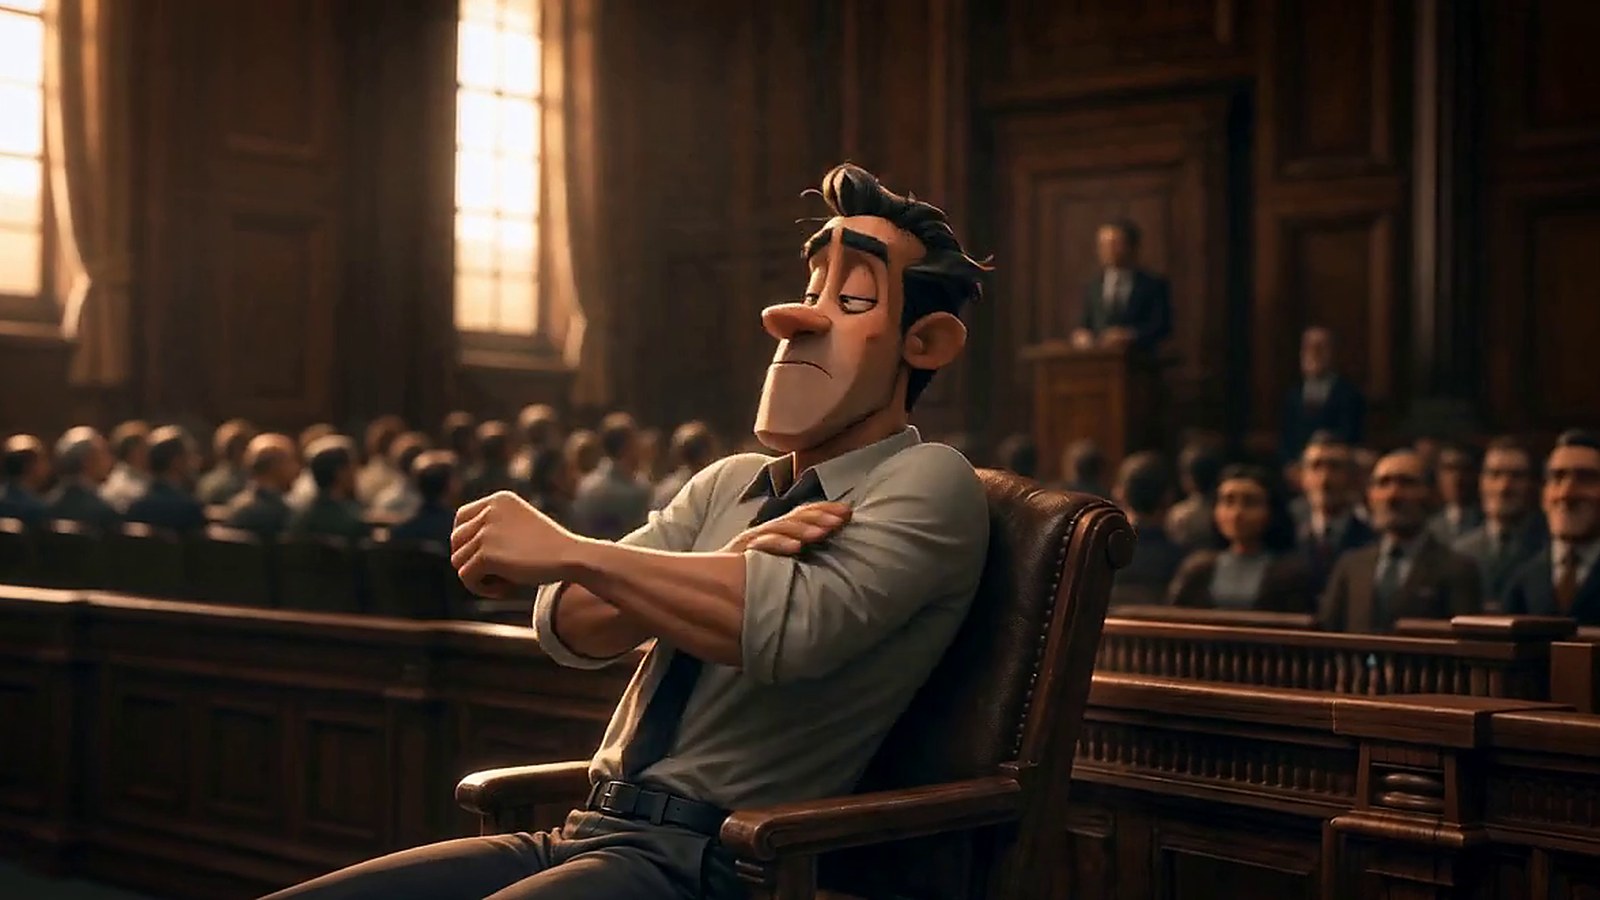
一张脸从头到尾只做一件事:不认罪。
六格故事板先按 3:4 竖页画满,再落成 16:9 的成片。被告不靠台词, 靠眉毛、上眼睑和嘴角三处同时维持同一个斜率——景别越近,这个斜率越不能变。
| 景别 | 控制点 | 画面 |
|---|---|---|
| 全景 | 先给场 | 顶光、对称轴线 |
| 中景 | 姿态先立住 | 抱臂、后仰 |
| 中近景 | 只给视线 | 法官正面 |
| 中近景 | 斜率不变 | 被告侧脸 |
| 中景 | 身体不动 | 律师指向被告 |
| 特写 | 最紧一格 | 眼睑与嘴角 |
故事板共两页,缩略图取自第一页。第二页与逐镜记录可在联系时索取。
《自信的被告》完整成片 · 15 秒 · 有声 / 点击播放
拆解
AI 音乐短片 · 2 分 26 秒 · 三重身份
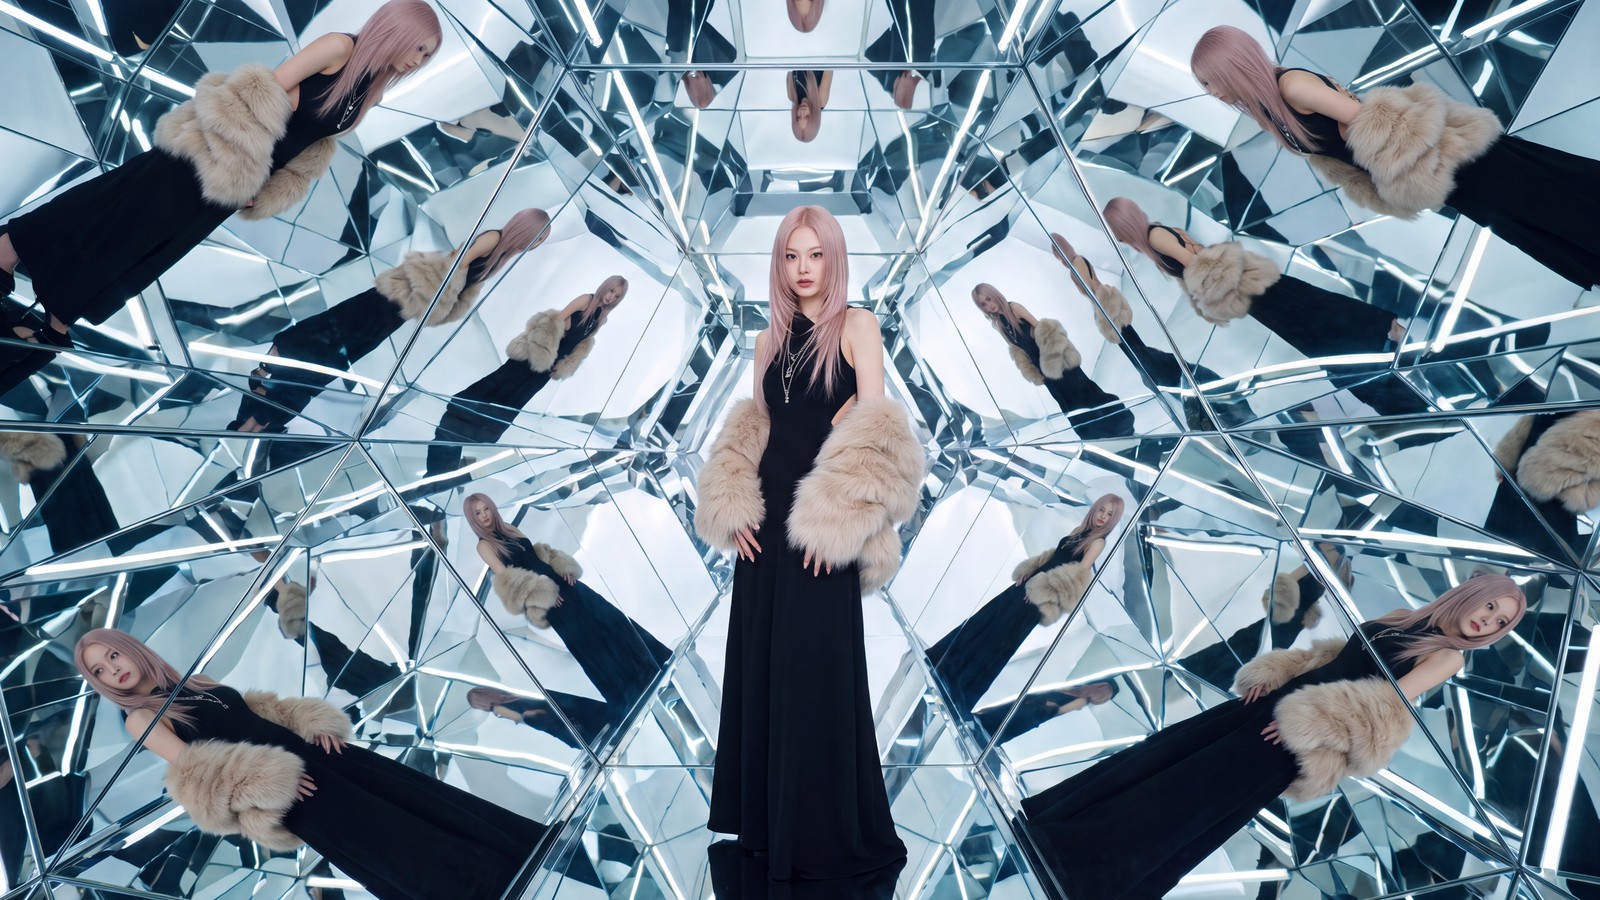
舞台、赌桌、镜屋,三个地方共用同一张脸。
红丝绒舞台、绿呢赌桌和镜面立方三套景轮流接管画面;镜头不解释剧情, 只负责让同一张脸在每种光里都像另一个人。
| 场景 | 视觉锚点 | 作用 |
|---|---|---|
| 舞台 | 红丝绒、悬浮肖像 | 先让她被看见 |
| 赌桌 | 绿呢、动物头、筹码 | 把权力摆上桌 |
| 镜屋 | 无限反射、同一张脸 | 让她分裂成多个 |
完整 MV 2 分 26 秒;三张静帧取自同一套设定。
《但那不是我》完整 MV · 2 分 26 秒 · 有声 / 点击播放
拆解
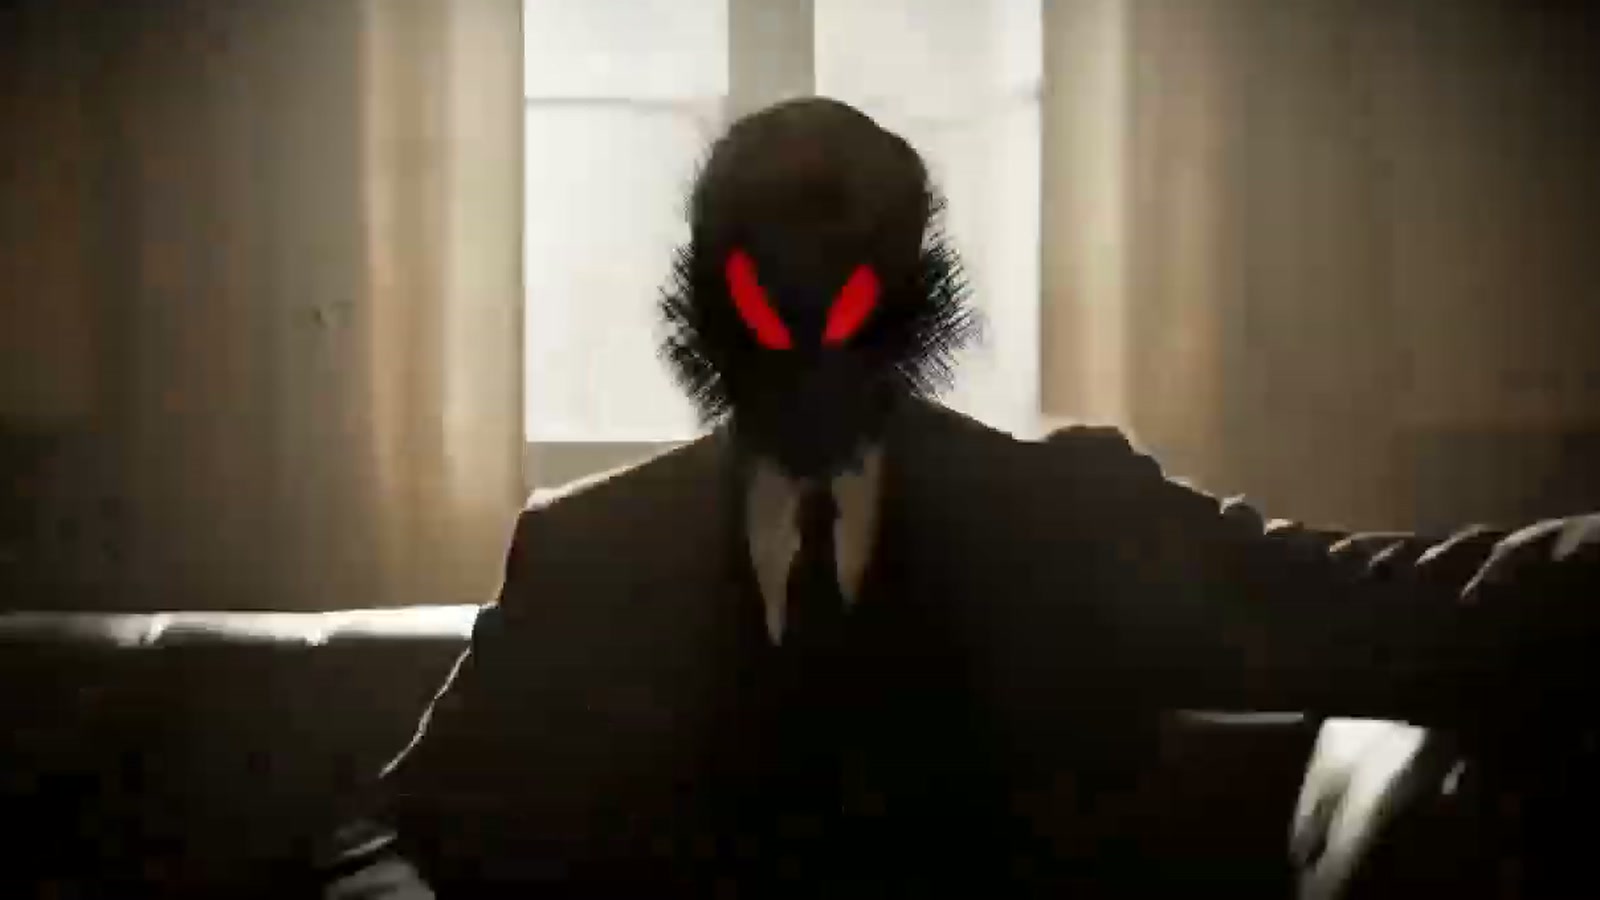
AI 短剧 · 3 × 15 秒 · 三种题材
三条片子共用一套生成流程,各走一种风格。
黑色电影、2D 动画、拼贴实验各一条。每条只有十五秒, 开场三秒内就得交代清楚人物、空间和下一步——慢一步,片子就没了。
| 片子 | 风格 | 第一眼给什么 |
|---|---|---|
| 盗者 | 黑色电影 | 一双红眼睛 |
| 短 2D | 2D 动画 | 一座巨型钟面 |
| 短创 2D | 拼贴实验 | 一整片红 |
三条均 15 秒、带声音;右侧拆解栏可以直接切换成片。
《盗者》· 15 秒 · 有声 / 点击播放
三条片子
拖拽穿越 · ← → 换帧 · 点击看判断 横向滑动 · 点击看判断
十二帧,从一张脸到一座城;拖拽穿越暗房,每一帧只留一个判断。
01 / 12
不是生成之后再挑,而是在分镜阶段就把不可行的镜头拿掉。 这套方法在每个项目的分镜阶段跑通,现在固化成了团队可以直接调用的流程。
分镜阶段
逐镜标注:可生成 / 需降级 / 不可生成,并给出精确替代路径。不是生成后发现问题,是生成前阻止问题。
配额节省 67%
生成之前
创意超出模型能力时不硬刚,与导演确认 L1 / L2 / L3 三套替代方案,每条标注品牌信息损失度与预估后期工时。
致命废片率 6.7% → 0%
测试期
用最不稳定的模型 + 3 次生成硬上限 + 零后期修复,主动测出体系的真正边界,再把结果回填进能力地图。
废片率 40% → 0%
已还原 / ALIGNED
03 / 03
三条判断跑完 · 0 废片
像这颗自己打乱的魔方——AI 的混乱,可以被一手转回有序。可拖动
我 2027 年 6 月毕业,湖南工程学院环境设计专业,想找视觉导演 / AIGC 方向的实习。 告诉我项目和时间线,我会先回一份可执行的视觉判断:哪些镜头值得生成,哪些直接实拍。